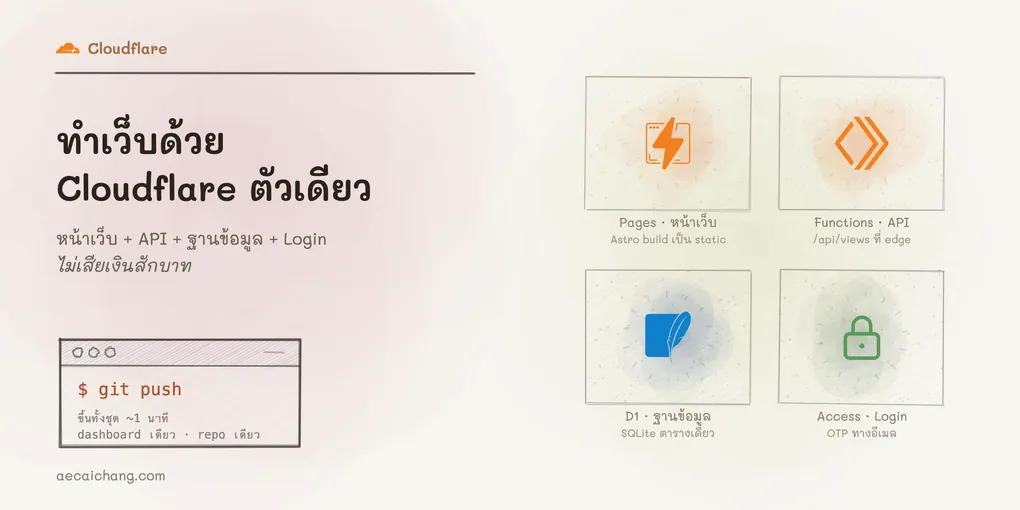
บล็อกนี้เคยเป็นเว็บ static ที่พึ่งบริการอื่นเต็มไปหมด hosting อยู่ที่หนึ่ง ตัวนับคนอ่านอยู่อีกที่ (hits.sh) จะทำหน้าแอดมินก็ต้องไปหา OAuth server อีกที่ พอมีอะไรพัง ก็ต้องไล่เปิด dashboard สามสี่อัน
วันนี้ทุกอย่างอยู่บน Cloudflare ตัวเดียว หน้าเว็บ, API, ฐานข้อมูล และหน้า login ของแอดมิน
ค่าใช้จ่าย 0 บาท ไม่มี server ให้ดูแล และ git push ครั้งเดียวขึ้นหมดทั้งชุด
โพสต์นี้เล่าตั้งแต่ ทำไมถึงเลือกแบบนี้ ไล่ทีละชิ้นว่าแต่ละส่วนทำหน้าที่อะไร กับดักที่ผมเจอจริงระหว่างทาง แล้วปิดท้ายด้วยว่าแนวคิดนี้เอาไปใช้กับงานแบบไหนได้อีก
ทุกอย่างในโพสต์คือระบบที่รันอยู่บนบล็อกนี้จริง ตัวนับ “อ่านแล้ว N ครั้ง” ที่อยู่ท้ายบทความนี้ ก็คือของที่กำลังจะเล่า
ก่อนอื่น: ทำไมต้องรวมที่เดียว
ตอนคิดจะทำ view counter เอง ผมเปิดตัวเลือกไว้ 4 แบบ
| แนวทาง | ข้อดี | ข้อเสีย | ค่าใช้จ่าย |
|---|---|---|---|
| ใช้บริการนับต่อไป (hits.sh) |
|
|
ฟรี |
| Hosting เดิม + Supabase (Postgres) |
|
|
ฟรีแบบมีเงื่อนไข |
| VPS เล็กๆ + SQLite |
|
|
~150 บาท/เดือน |
| Cloudflare ทั้งชุดตัวที่เลือก |
|
|
ฟรี |
เกณฑ์ที่ผมใช้ตัดสินมี 3 ข้อ เรียงตามน้ำหนัก
- ไม่มีอะไรให้ดูแลตอนตีสาม ไม่มี server ไม่มี process ไม่มี disk เต็ม
- ทุกอย่างอยู่ใน git ถ้าพรุ่งนี้ต้องย้าย ต้องมีไฟล์ config ที่บอกว่าระบบประกอบด้วยอะไร ไม่ใช่จำจาก dashboard
- ค่าใช้จ่ายเป็นศูนย์จริงๆ ที่ปริมาณของบล็อกส่วนตัว ไม่ใช่ “ฟรี 14 วัน”
Cloudflare ผ่านทั้ง 3 ข้อ และเว็บอยู่บน Pages อยู่แล้ว ส่วนที่ต้องเพิ่มคือ Functions, D1 กับ Access เท่านั้น
แผนที่บริการ: อันไหนใช้ตอนไหน
Cloudflare มีของเยอะจนงง ตารางนี้คือที่ผมใช้ตัดสินใจ
| บริการ | มันคืออะไร | ใช้เมื่อ | ในโปรเจกต์นี้ |
|---|---|---|---|
| PagesFE | hosting สำหรับ static site ต่อกับ git | มี build output เป็นไฟล์ HTML/JS | เว็บ Astro ทั้งหมด |
| Pages FunctionsBE | โค้ดฝั่ง server ที่วางไว้ในโฟลเดอร์ functions/ ของโปรเจกต์ Pages |
ต้องการ API เล็กๆ ข้างเว็บ ไม่อยากแยก repo | /api/views/* |
| Workers | Functions แบบเดี่ยวๆ ไม่ผูกกับ Pages | API ที่ไม่มีหน้าเว็บ, cron, proxy | ไม่ได้ใช้ |
| D1DB | ฐานข้อมูล SQLite บน edge | ข้อมูลมีโครงสร้าง ต้อง query, นับ, รวมยอด | ตาราง views |
| KV | key-value เก็บค่าเดี่ยว อ่านเร็วมาก เขียนแล้วกระจายทั่วโลกใน ~60 วิ | cache, config, feature flag | ไม่ได้ใช้ดูเหตุผลข้างล่าง |
| R2 | object storage แบบ S3 ไม่มีค่า egress | เก็บไฟล์ รูป วิดีโอ | ไม่ได้ใช้รูปอยู่ใน git |
| Access (Zero Trust)Login | หน้า login วางหน้า path ไหนก็ได้ ไม่ต้องแก้โค้ด | ล็อกหน้าแอดมิน, staging, docs ภายใน | /admin/* |
ทำไม D1 ไม่ใช่ KV สำหรับตัวนับ KV เขียนแล้วอ่านกลับได้ค่าเดิมอยู่พักหนึ่ง (eventual consistency)
ถ้าคน 2 คนเปิดหน้าเดียวกันพร้อมกัน ค่าที่ +1 ไปอาจทับกันหาย ส่วน D1 ทำ
UPDATE count = count + 1 ใน transaction เดียว ไม่หาย และผมอยาก SUM() ยอดรวมทั้งเว็บ
ซึ่ง KV ทำไม่ได้ ต้องไล่อ่านทุก key เอง
ทำไม Pages Functions ไม่ใช่ Worker แยก เพราะ API นี้มีชีวิตอยู่เพื่อเว็บนี้เท่านั้น อยู่ใน repo เดียวกัน deploy พร้อมกัน ไม่ต้องจัดการ CORS ไม่ต้องจำว่า Worker ชื่ออะไร ถ้าวันหนึ่งมีเว็บอื่นมาใช้ API เดียวกัน ค่อยแยกเป็น Worker
สิ่งที่จะสร้าง
ภาพรวมทั้งระบบมีแค่นี้
- คนอ่านเปิดบทความเข้าหน้า /blog/...
- FEPagesส่งหน้า HTML ที่ build ไว้แล้ว
- BEFunctionsbrowser เรียก API ขอนับ 1
- DBD1บวกหนึ่ง แล้วคืนยอดล่าสุด
- ผลลัพธ์อ่านแล้ว 13 ครั้งโชว์ท้ายบทความ
3 endpoint, 1 ตาราง, โค้ดฝั่ง server ประมาณ 60 บรรทัด ที่เหลือคือการตั้งค่าให้แต่ละชิ้นรู้จักกัน
ลงมือ
ของที่ต้องมีก่อนมีอย่างเดียว คือเว็บ static สักตัว (Astro, Next export, Hugo อะไรก็ได้)
ที่ deploy บน Cloudflare Pages ผ่าน git อยู่แล้ว เครื่องมือฝั่งเครื่องเราใช้ wrangler ซึ่งเป็น CLI ของ Cloudflare
ตัวเดียวจบ ทั้งสร้าง DB รันเว็บในเครื่อง และสั่ง query
โพสต์นี้จะไม่แปะโค้ดทั้งไฟล์ เพราะโค้ดจริงสั้นมาก และหน้าตาเปลี่ยนไปตามเฟรมเวิร์กที่ใช้ สิ่งที่อยากให้ติดกลับไปคือ แต่ละชิ้นทำหน้าที่อะไร และทำไมถึงออกแบบแบบนั้น
ขั้นที่ 1: ฐานข้อมูล ตารางเดียว เก็บแค่ยอด
สร้าง D1 ด้วยคำสั่ง wrangler บรรทัดเดียว แล้วสร้างตาราง views ที่มีช่องสำคัญแค่ 2 ช่อง
คือ slug (ชื่อบทความ) กับ count (ยอดอ่าน)
ไม่ต้องเก็บ log ว่าใครอ่านเมื่อไหร่ เพราะคำถามที่อยากตอบมีแค่ “กี่ครั้ง” ถ้าวันหนึ่งอยากรู้ว่า “ใคร เมื่อไหร่” ค่อยเพิ่มตารางทีหลัง อย่าออกแบบเผื่อ ตารางที่เล็กที่สุดที่ยังตอบคำถามได้ คือตารางที่ดูแลง่ายที่สุด
ขั้นที่ 2: ผูก DB เข้ากับเว็บด้วยไฟล์ config ใน repo
Pages ต้องรู้ว่าเว็บนี้ใช้ DB ก้อนไหน วิธีบอกคือไฟล์ wrangler.jsonc ที่ root ของ repo
ในไฟล์มีแค่ชื่อ Pages project, ชื่อ DB และชื่อที่โค้ดจะใช้เรียก DB ตัวนี้ (เรียกว่า binding ของผมตั้งว่า VIEWS)
ไฟล์นี้คือหัวใจของข้อ “ทุกอย่างอยู่ใน git” พอ push ขึ้นไป Pages จะอ่านแล้วผูก DB ให้เอง ไม่ต้องไปกดใน dashboard และใครมาอ่าน repo ก็รู้ทันทีว่าระบบต่อกับอะไรบ้าง ต่างจากการตั้งค่าใน dashboard ที่วันหนึ่งจะไม่มีใครจำได้ว่าไปกดอะไรไว้
ขั้นที่ 3: API ที่ชื่อไฟล์คือ URL
Pages Functions ทำงานแบบเดียวกับหน้าเว็บ คือ ตำแหน่งไฟล์กำหนด URL
วางไฟล์ไว้ในโฟลเดอร์ functions/api/views/ ก็ได้ endpoint /api/views/... ทันที ไม่ต้องตั้ง router
ระบบนี้มี 3 endpoint
- นับหนึ่งครั้ง แล้วคืนยอดล่าสุดของบทความนั้น
- อ่านยอดของบทความเฉยๆ ไม่นับเพิ่ม
- อ่านยอดรวมทั้งเว็บ ให้ footer ใช้
แนวคิดที่สำคัญที่สุดของฝั่ง API มี 2 ข้อ
นับด้วยคำสั่งเดียว ถ้าเขียนแบบตรงไปตรงมาคือ อ่านยอดเดิม บวกหนึ่ง แล้วเขียนกลับ ถ้ามีคน 2 คนเปิดพร้อมกัน ทั้งคู่จะอ่านได้ 12 แล้วต่างคนต่างเขียน 13 ทับกัน ยอดหายไปหนึ่ง SQLite มีคำสั่งที่ทำ 3 อย่างในจังหวะเดียว คือสร้างแถวถ้ายังไม่มี บวกหนึ่งถ้ามีแล้ว และคืนค่าล่าสุดกลับมา
INSERT INTO views (slug, count) VALUES (?, 1)
ON CONFLICT(slug) DO UPDATE SET count = count + 1
RETURNING count
อย่าเชื่อ slug ที่มากับ URL ค่านี้ใครก็พิมพ์มาได้ ถ้าไม่กรอง ใครก็ยิงชื่อมั่วๆ มาสร้างแถวขยะใน DB ได้เป็นพันแถว
ผมกรองให้ผ่านเฉพาะตัวอักษร ตัวเลข - กับ _ ส่วนภาษาไทยมีรายละเอียดที่ผมพลาดไป
เล่าไว้ในหัวข้อกับดักข้างล่าง
ขั้นที่ 4: หน้าเว็บ ตัวนับเป็นของประดับ
ฝั่งหน้าเว็บมีแค่ script สั้นๆ ที่เรียก API ตอนเปิดหน้า แล้วเอาตัวเลขมาใส่ มีการตัดสินใจเล็กๆ 2 ข้อ
- ซ่อนไว้ก่อน แล้วค่อยโชว์เมื่อ API ตอบ ถ้า API ล่ม คนอ่านไม่เห็นอะไรผิดปกติเลย ตัวนับเป็นของประดับ ไม่ควรทำให้หน้าเว็บดูพัง
- เปิดหน้า 1 ครั้ง = 1 view ไม่กันนับซ้ำ ไม่ใช้ cookie เพราะ hits.sh ของเดิมก็นับแบบนี้ และผมไม่อยากเก็บอะไรเกี่ยวกับคนอ่านเลย ถ้าอยากนับแบบไม่ซ้ำคน ค่อยเพิ่มทีหลัง
ขั้นที่ 5: ทดสอบในเครื่องก่อนปล่อย
จุดที่สะดุดครั้งแรกคือ dev server ของ Astro ไม่รัน Pages Functions มันรู้จักแค่หน้าเว็บ จะทดสอบ API ต้อง build เว็บก่อน แล้วให้ wrangler เป็นคนเสิร์ฟ ซึ่งจะจำลองทั้ง Pages, Functions และ D1 ในเครื่อง D1 ในเครื่องเป็นคนละก้อนกับของจริงด้วย ต้องสร้างตารางซ้ำอีกรอบ
นิสัย QA ที่ติดมาคือ ไม่เชื่อว่าเสร็จจนกว่าจะลองทั้งทางที่ควรผ่านและทางที่ควรล้ม เคสที่ควรลองมีแค่นี้
| ลองอะไร | ควรได้ | ทำไมต้องลอง |
|---|---|---|
| เปิดบทความเดิม 2 ครั้ง | ยอดขึ้น 1 แล้ว 2 | เช็คว่าบวกเพิ่มจริง ไม่ใช่เขียนทับ |
| ขอยอดรวมทั้งเว็บ | เท่ากับผลรวมทุกบทความ | footer ทุกหน้าใช้ตัวเลขนี้ |
ส่ง slug เป็น ../etc |
ถูกปฏิเสธ | กันคนแอบส่ง path แปลกๆ มาสร้างแถวขยะ |
| ส่ง slug ภาษาไทยที่มีวรรณยุกต์เคยพลาด | นับได้ปกติ | ข้อนี้ผมลืมลองในรอบแรก เล่าไว้ในหัวข้อกับดัก |
| ปิด API ทิ้ง แล้วเปิดหน้าเว็บ | หน้าปกติ แค่ไม่มีตัวเลข | ตัวนับห้ามทำให้หน้าเว็บพัง |
ขั้นที่ 6: ย้ายยอดเดิมไม่ให้หาย
ยอดเดิมอยู่ที่ hits.sh ผมไม่อยากให้ footer เด้งจาก 400 กว่าเป็น 0 hits.sh ไม่มี API ให้ดึง แต่ในไฟล์ป้าย SVG ของมันมีตัวเลขเขียนอยู่ เปิดอ่านได้ตรงๆ ได้ยอดรวม 426 แล้วเอาไปใส่ D1 ก่อนเปิดใช้งาน โดยยึด 3 หลัก
- ยอดที่ไม่รู้ว่าเป็นของบทความไหน ใส่เป็นแถวพิเศษ ผมตั้งชื่อแถวว่า
_siteยอดรวมจะได้ต่อจากเดิมพอดี - ใส่แบบที่รันซ้ำได้โดยไม่ทับของเดิม ถ้ามีแถวอยู่แล้วให้ข้ามไป กันพลาดไปทับยอดที่เพิ่งนับ
- ชื่อแถวต้องตรงกับที่หน้าเว็บส่งมาจริง บทความเรื่อง Astro ของผมชื่อไฟล์เป็นภาษาไทย แต่ URL จริงใช้ slug ภาษาอังกฤษที่ตั้งไว้ใน frontmatter ถ้าใส่ยอดด้วยชื่อไฟล์ ยอดจะไปอยู่แถวที่ไม่มีใครเรียก
จากนั้น git push ครั้งเดียว Pages จะ build เว็บ ผูก D1 และ deploy Functions ให้ในรอบเดียว
ประมาณ 1 นาที เปิดเว็บจริงดู footer ขึ้น 426 ตรงกับป้ายเดิม
ขั้นที่ 7: ล็อกหน้าแอดมินโดยไม่แตะโค้ด
บล็อกนี้มีหน้า /admin/ (Sveltia CMS สำหรับแก้โพสต์จากมือถือ) ที่เมื่อก่อนใครก็เปิดดูได้
ถึงจะแก้อะไรไม่ได้ถ้าไม่มี token แต่ผมไม่อยากให้เห็นด้วยซ้ำ
Cloudflare Access ทำให้โดยไม่ต้องแก้โค้ดสักบรรทัด ตั้งใน dashboard Zero Trust → Access → Applications
- Add an application แล้วเลือก Self-hosted
- ใส่โดเมน
aecaichang.comกับ pathadmin - ตั้ง Policy ให้ผ่านเฉพาะอีเมลตัวเอง
- วิธี login เลือก One-time PIN ซึ่งเป็นค่าเริ่มต้น ส่งรหัสเข้าอีเมล ไม่ต้องตั้ง Google หรือ GitHub
- ให้จำการ login ไว้ 1 เดือน
เสร็จแล้วทุก request ที่มาที่ /admin/ จะโดนดักที่ edge ก่อนถึงไฟล์ ไม่ว่าจะเป็นหน้าเว็บหรือไฟล์ config
ลองเปิดจากเครื่องที่ไม่เคย login จะเจอหน้ากรอกอีเมลของ Cloudflare แทนหน้าแอดมิน
ตรงนี้เป็นข้อที่ผมชอบที่สุดของการอยู่ที่เดียวกัน: DNS, hosting, และ auth อยู่ในมือเดียวกัน เลยวาง login ไว้ตรง path ไหนก็ได้โดยที่แอปไม่ต้องรู้ตัว
กับดักที่เจอจริง
เก็บไว้ให้คนที่จะทำตาม จะได้ไม่เสียเวลาแบบผม
- ชื่อ project ในไฟล์ config ต้องตรงเป๊ะ ถ้าไม่ตรง Pages จะเฉยๆ ไม่ error สักคำ แต่ DB ไม่ถูกผูก ไปรู้ตัวอีกทีตอน API พังบนเว็บจริง
- dev server ของเฟรมเวิร์กไม่รัน Functions อย่าเสียเวลาหาว่าทำไม API ตอบ 404 ในเครื่อง ต้องทดสอบผ่าน wrangler
- DB ในเครื่องกับของจริงคนละก้อน สร้างตารางต้องทำ 2 รอบ ข้อดีคือข้อมูลทดสอบไม่ขึ้นไปปนของจริง
- Access ล็อกทุกอย่างใต้ path นั้น รวมไฟล์ config ของ CMS ด้วย ดีสำหรับความปลอดภัย แต่ถ้ามีระบบอื่นต้องอ่านไฟล์ในนั้น มันจะโดนล็อกไปด้วย ต้องแยก path
- login Cloudflare ไว้หลาย account แล้ว wrangler ไม่เดาให้ ของผมมีทั้งส่วนตัวและที่ทำงาน
ต้องบอกก่อนว่าจะใช้ account ไหน ผ่านตัวแปร
CLOUDFLARE_ACCOUNT_ID - ตัวกรองภาษาไทยต้องรู้จักวรรณยุกต์ อันนี้เจอหลังระบบขึ้นไปแล้วหนึ่งสัปดาห์
ตอนตรวจโพสต์นี้ก่อนปล่อย ผมให้ Claude Code ไล่ลองระบบจริงตามที่เขียนไว้ในโพสต์
แล้วมันลองนับบทความที่ชื่อเป็นภาษาไทย ผลคือโดนปฏิเสธ ทั้งที่คอมเมนต์ในโค้ดเขียนว่ารองรับภาษาไทย
สาเหตุคือ regex ที่ผมใช้รู้จักแค่ “ตัวอักษร” (
\p{L}) ซึ่งครอบพยัญชนะไทย แต่ไม้เอก ไม้โท การันต์ สระอุ สระอู ถูกนับเป็น “เครื่องหมายกำกับ” (\p{M}) คำอย่าง “ช่วย” จึงไม่ผ่าน แก้ด้วยการเพิ่ม\p{M}เข้าไปตัวเดียว ที่ไม่มีใครเห็นเพราะบทความเดียวที่ชื่อไฟล์เป็นภาษาไทยบังเอิญตั้ง slug อังกฤษไว้ บั๊กเลยนอนรออยู่เงียบๆ และเพราะตัวนับซ่อนตัวเองตอน API ตอบไม่ได้ ก็จะไม่มีใครรู้ด้วย บทเรียนคือ ของที่ออกแบบให้พังแบบเงียบๆ ต้องมีเคสทดสอบที่ตั้งใจหาจุดพังเงียบๆ นั้นด้วย
ค่าใช้จ่ายและขีดจำกัด
ตัวเลข free tier ณ วันที่เขียน (กันยายน 2026) เช็คหน้า pricing อีกทีก่อนตัดสินใจ
| บริการ | ฟรีได้ถึง | บล็อกนี้ใช้จริง |
|---|---|---|
| PagesFE |
|
30–40 builds/เดือน |
| Pages FunctionsBE |
|
หลักสิบ/วัน |
| D1DB |
|
หลักร้อยแถว/วันDB ทั้งก้อน 20 KB |
| AccessLogin |
|
1 user |
ถ้าโต 100 เท่าก็ยังไม่ต้องจ่าย ถ้าโต 1,000 เท่าค่อยคุยกัน
“ไม่เสียเงินสักบาท” ในชื่อโพสต์หมายถึงค่า hosting, API, DB และ login
ค่าโดเมนรายปียังจ่ายเหมือนเดิม ซึ่งจ่ายอยู่แล้วไม่ว่าจะ host ที่ไหน
ถ้ายังไม่มีโดเมน ใช้ <ชื่อโปรเจกต์>.pages.dev ที่ Pages ให้มาฟรีได้เลย
D1 นับเป็น “แถว” ไม่ใช่ “ครั้ง” ข้อนี้ต้องเข้าใจก่อนออกแบบ query
footer ของผมรัน SUM(count) ทุกหน้า ซึ่งอ่านทุกแถวในตาราง ตอนนี้มี 6 แถว (รวมแถวของบทความนี้)
ก็คือเปิดหน้าเว็บ 1 ครั้งกิน 6 แถว ถ้าวันหนึ่งมีบทความ 1,000 เรื่อง ก็ 1,000 แถวต่อการเปิดหน้า
ยังห่างจาก 5 ล้านมาก แต่ถ้าเป็นตารางที่โตไม่หยุด (log, event) ต้องคิดเรื่อง index หรือเก็บยอดรวมแยกไว้แต่แรก
ตั้งแต่ 1 กันยายน 2026 เกินโควตาฟรีแล้ว query จะ error จนถึงเที่ยงคืน UTC (7 โมงเช้าบ้านเรา)
ข้อมูลไม่หาย แต่อ่านเขียนไม่ได้ ตรงนี้คือเหตุผลที่ตัวนับต้อง hidden ไว้ก่อนตามขั้นที่ 4
วันที่โควตาหมด หน้าเว็บยังอ่านได้ปกติ แค่ตัวเลขหายไป
ขีดจำกัดที่ต้องรู้ก่อนเลือกทางนี้
- Functions/Workers แผนฟรีได้ CPU time 10 ms ต่อ request (เวลารอ DB ไม่นับ) ไม่เหมาะกับงานคำนวณหนัก เช่นย่อรูป หรือ parse ไฟล์ใหญ่
- D1 เป็น SQLite มี full-text search (FTS5) กับ JSON function ให้ใช้ แต่ไม่มี stored procedure และลง extension เองแบบ Postgres ไม่ได้ (ไม่มี pgvector, PostGIS) ถ้าโปรเจกต์พึ่งของพวกนั้นอยู่ อย่าฝืน
- D1 มีฐานหลักอยู่ region เดียว ของผมอยู่ APAC และ query วิ่งไปที่สิงคโปร์ มี read replica กระจายทั่วโลกให้เปิดใช้ฟรี แต่ต้องเขียนโค้ดผ่าน Sessions API ถ้าคนอ่านส่วนใหญ่อยู่ไทย ไม่ต้องสนใจข้อนี้
เอาแนวคิดนี้ไปใช้กับงานอื่น
โครง static site + Functions + D1 + Access ใช้ซ้ำได้กับของพวกนี้โดยเปลี่ยนแค่ตารางกับ endpoint
| งาน | ตาราง | endpoint | ล็อกด้วย Access ไหม |
|---|---|---|---|
| ปุ่ม like / bookmark | likes(slug, count) |
POST / |
ไม่ |
| ฟอร์มติดต่อ / สมัครรับข่าว | messages(id, email, body, created_at) |
POST / |
ใช่เฉพาะหน้าดูข้อความ |
| Comment สำหรับเอกสารภายใน | comments(page, author, body, created_at) |
GET/POST / |
ใช่ทั้งเว็บ |
| Poll / โหวต | votes(poll, option, count) |
POST / |
แล้วแต่เฉพาะหน้าผลโหวต |
| Dashboard ภายในทีมผมใช้อยู่ | อะไรก็ได้ | อะไรก็ได้ | ใช่ผูกกับ Google Workspace ของบริษัท |
ที่ทำงานผมใช้แบบสุดท้ายกับเว็บเอกสารระบบ: Astro + D1 เก็บ comment ของ QA/BA ต่อหน้า แล้ว Access ล็อกทั้งเว็บด้วยอีเมลบริษัท ไม่มีใครต้องสร้าง user ไม่มี password ให้ลืม
เมื่อไหร่ที่ไม่ควรใช้ทางนี้
- ต้องการ Postgres จริงๆ (join ซับซ้อน, extension, ORM ที่ทีมคุ้น)
- มี background job ที่รันนานเป็นนาที
- ทีมอยู่บน AWS/GCP อยู่แล้ว และมีคน ops ดูแล การเพิ่ม vendor ที่สามอาจแพงกว่าที่คิด
สรุป
สิ่งที่ได้จากงานนี้ไม่ใช่แค่ตัวนับที่นับตรงขึ้น แต่คือ โครงที่ใช้ซ้ำได้ สำหรับเว็บเล็กๆ ที่อยากมีฝั่ง server นิดหน่อยโดยไม่ต้องมี server
- ไฟล์ใน
functions/= API - ไฟล์
wrangler.jsonc= คำอธิบายว่าระบบต่อกับอะไร - ตั้งค่า Access 5 ข้อ = หน้า login
ทั้งหมดอยู่ใน repo เดียว push ครั้งเดียว และถ้าจะเลิกใช้ก็ลบ 2 โฟลเดอร์กับ 1 ไฟล์
ถ้าจะเริ่ม เริ่มจากตัวนับแบบนี้แหละครับ เล็กพอที่พังแล้วไม่มีใครเดือดร้อน แต่ครบพอที่จะได้แตะทุกชิ้นส่วน พอทำเสร็จจะรู้เลยว่างานถัดไปควรวางตรงไหน