ถ้าย้อนกลับไปสักสองปีก่อน แล้วมีคนบอกให้ QA ว่า “ไปแก้ BUG ที่ลูกค้าแจ้งมาให้หน่อย” ผมคงหัวเราะแล้วตอบว่า เป็นไปไม่ได้หรอก เพราะเราเป็น QA มาตลอด เขียนโค้ดไม่เป็นเว้ย!!! อ่านโค้ดพอออก เขียนสคริปต์ทดสอบพอได้ แต่ให้แก้ไขระบบจริงที่ลูกค้าใช้งานทุกวัน อันนั้นมันงานของ Developer
แต่วันนี้ผมกำลังเขียนบล็อกตอนนี้อยู่ หลังจากระบบที่ว่านั้นขึ้น Production และมีผู้ใช้งานจริงหลายร้อยคนใช้อยู่ทุกวัน โดยที่คนเขียนโค้ดหลักของโปรเจกต์คือผมเอง กับ Tools ที่ชื่อว่า AI
โพสต์นี้คือบันทึกของเส้นทางนั้นทั้งเส้น ตั้งแต่วันแรกที่รับโจทย์ จนถึงวันที่ลูกค้าโอเคกับระบบ สามารถจบงานและวางบิลในงวดสุดท้ายได้ ผมจะเล่าตามลำดับเวลา พร้อมบทเรียนที่เก็บได้ระหว่างทาง
จุดตั้งต้น — โจทย์ที่ใหญ่กว่าตัว
โปรเจกต์ที่ว่าคือระบบจัดการขนส่งพนักงานขนาดใหญ่ของลูกค้ารายหนึ่ง ประกอบด้วยเว็บหลังบ้านสำหรับเจ้าหน้าที่ แอปมือถือสำหรับคนขับรถ และหัวใจสำคัญที่สุดคือระบบคิดเงินค่าขนส่ง ที่ต้องรองรับสัญญาหลายรูปแบบ รถหลายประเภท และเงื่อนไขทางธุรกิจที่ซับซ้อนมาก
ด้วยปัญหาหลายอย่างของโปรเจกต์ (ซึ่งขอไม่ลงรายละเอียดตรงนี้แล้วกันครับ) ทำให้ไม่มีนักพัฒนาคนไหนสามารถมารับช่วงดูแลโปรเจกต์นี้ต่อได้เลย สถานการณ์ตอนนั้นเหมือนเรือที่กำลังวิ่งอยู่กลางทะเลแต่ไม่มีคนคุมท้ายเรือ
ด้วยความรู้สึกส่วนตัวที่ไม่อยากเห็นงานลอยแพ + เราเป็น PM/QA ที่ดูแลโปรเจกต์นี้มาตั้งแต่ต้นด้วย เลยอยากดันโปรเจกต์นี้ให้จบลงให้ได้ อารมณ์นั้นคือ Developer ไม่มีเวลาแก้งานให้ใช่ไหม เดี๋ยวผมขอลองแก้เองก็ได้ ด้วยเหตุนี้งานจึงตกมาอยู่ที่ผมซึ่งตำแหน่งจริงคือ QA ความรู้สึกตอนนั้นยอมรับตรงๆ ว่ากลัวครับ กลัวว่าจะทำไม่ได้ กลัวว่าจะทำระบบพัง กลัวไปหมดทุกอย่างเลย แต่อีกใจหนึ่งก็คิดว่า ในเมื่อตอนนี้เรามี AI ที่เก่งขึ้นทุกวัน ถ้าไม่ลองตอนนี้แล้วจะไปลองตอนไหน
แล้วส่งต่อให้งานที่เกี่ยวข้อง
ตั้งหลักก่อนลุย — ไม่ใช่แค่ “สั่ง AI แล้วรอ”
ช่วงแรกผมยังไม่กล้าแตะหลังบ้านเต็มตัวหรอกครับ เพราะในหัวยังคิดว่าเราไม่ใช่ Developer สายตรง จะไปกล้าแตะระบบ Production ที่ลูกค้าใช้จริงได้ยังไง
จุดเริ่มต้นเลยเป็นแค่การขยับไปช่วยแก้ส่วนหน้าบ้าน (Frontend) เป็นหลักก่อน เช่น
- ปรับแก้ปุ่ม แก้ไข UI ให้สวยงามและใช้งานง่ายขึ้น
- ซ่อน toolbar ของกราฟ
- ปรับ filter ให้ค้นหาง่ายขึ้น
- แก้ข้อความที่เขียนผิด
แก้กันครั้งละไม่กี่บรรทัด พอเริ่มจับทางได้ ผมเลยเอ่ยปากขอทีมพัฒนาว่า “อยากลองขยับไปแก้ระบบหลังบ้าน (Backend) ด้วย”
ช่วงแรกเราตกลงกติกากันไว้ว่า ทุกอย่างที่ผมหรือ AI เขียน ทีม Developer จะ Review Code ให้ก่อนขึ้น Production ส่วน Logic การทำงานเป็นความรับผิดชอบของผมเอง ผ่านไปสักระยะ พอทีมเห็นว่างานนิ่งและไม่หลุดมาตรฐาน ก็ไว้ใจให้ผมแก้และอัปเดตโค้ดขึ้นเองได้
เครื่องมือหลักที่ผมใช้ลุยตลอดทางคือ Claude Code ซึ่งเป็น AI agent ที่ทำงานใน Desktop App เป็นหลัก อ่านโค้ดทั้ง repository ได้ รันคำสั่งได้ แก้ไฟล์ได้ ไม่ใช่แค่แชทถามตอบ หน้าตาการทำงานจริงประมาณนี้ครับ ผมเล่าปัญหาเป็นภาษาไทยปกติ มันไปไล่อ่านโค้ดเองแล้วรายงานกลับมาว่าเจออะไร ก่อนจะลงมือแก้
หน้ารายงานโหลดช้ามากเวลาเลือกช่วงย้อนหลัง 3 เดือน ช่วยหาสาเหตุก่อน อย่าเพิ่งแก้
อ่าน 12 ไฟล์ ไล่ query ดู log
เจอแล้วครับ หน้านี้ยิง query ทีละแถวในลูป (N+1) พอช่วงเวลากว้างขึ้นเลยกลายเป็นหลายพัน query แก้ได้ 2 ทาง: รวมเป็น query เดียวด้วย join หรือทำ batch ทีละ 500 รายการ
เอาแบบ join แต่เขียนเทสคุมก่อน แล้วค่อยแก้ ห้ามแตะไฟล์ migration
เขียนเทส 4 เคส แก้ 2 ไฟล์ รัน type check รันเทส
เทสทั้งชุด 128 เคสผ่านหมด เวลาโหลดจาก 8.4 วินาที เหลือ 0.6 วินาที ไม่ได้แตะ migration ตามที่บอก — รบกวนอ่าน diff ก่อนอนุมัติครับ
นอกจากนี้ยังมี Gemini และ Codex ที่หยิบมาใช้ควบคู่กันตามความถนัดของแต่ละตัว เช่น ใช้สลับกันตรวจงาน หรือขอมุมมองที่สองเวลาไม่แน่ใจว่าแนวทางที่ได้มานั้นถูกจริงไหม
แต่สิ่งที่ผมเรียนรู้ช่วงแรกก็คือ ถ้าเรา “สั่งแล้วรอรับผล ขาดการรีวิวและ Feedback” ผลลัพธ์จะพังเร็วพอๆ กับที่ได้มา สิ่งที่ทำให้รอดจริงๆ คือการ ตั้งระบบให้ AI ทำงานแบบมีวินัย ซึ่งประกอบด้วย…
-
1. ตั้งกติกา
CLAUDE.md + rules
กฎที่ AI ต้องทำตาม -
2. AI ลงมือทำ
เขียนโค้ด แก้บั๊ก
ตามกติกาที่วางไว้ -
3. ตรวจซ้ำทุกชั้น
type check, lint, เทส
AI review ไขว้กันเอง -
4. คนตัดสินใจ
อ่าน ถาม สงสัย
แล้วค่อยอนุมัติ
ขั้นที่หนึ่ง “ตั้งกติกา” คือหัวใจของทั้งวงจร เพราะมันคือสิ่งที่ทำให้ AI ไม่ทำเกินขอบเขต หน้าตาของมันคือไฟล์ข้อความธรรมดาที่วางไว้ในโปรเจกต์ AI จะอ่านทุกครั้งก่อนเริ่มงาน ของผมย่อมาให้ดูประมาณนี้ (ตัดกฎที่ผูกกับระบบของลูกค้าออกแล้ว)
# ขอบเขตที่ห้ามข้าม
- ห้ามแก้ไฟล์ migration เอง ให้เสนอ SQL มาให้อ่านก่อนเสมอ
- ห้ามแตะ config ของ production ทุกกรณี
- ไม่แน่ใจ requirement ให้ถาม ห้ามเดาแล้วเขียนต่อ
# วิธีทำงาน
- แก้ business logic ต้องมีเทสคุมก่อนลงมือ
- เปลี่ยนอะไรหลายไฟล์ ให้วางแผนมาก่อน รอผมอนุมัติค่อยเริ่ม
- 1 PR = 1 เรื่อง ถ้าเกิน 300 บรรทัดให้ซอยเป็นหลายรอบ
# ก่อนบอกว่าเสร็จ
- รัน type check, lint และเทสทั้งชุดให้ผ่านก่อน
- สรุปให้ฟังว่าแก้อะไรไปบ้าง และอะไรที่ยังไม่ได้ทำ
- เจอปัญหาที่ควรจำ ให้จดลงไฟล์ memory ไว้ใช้รอบหน้า
เส้นทางในตัวเลข — จากแก้ทีละปุ่ม สู่รื้อทีละระบบ
ก่อนเล่าต่อ ผมอยากพักมาดูตัวเลขกันสักหน่อย เพราะตอนที่เขียนโพสต์นี้ ผมลองย้อนกลับไปเปิดประวัติ commit ของตัวเองในทุก repository ของโปรเจกต์ (ให้ AI ช่วยรวบรวมสถิติจาก git log นั่นแหละครับ) แล้วภาพที่เห็นมันเล่าเรื่องได้ดีกว่าคำพูด
ทั้ง 7 เดือนเรียงออกมาหน้าตาเป็นแบบนี้ครับ
-
ก.พ.~60 commitsหน้าบ้าน
ปรับปุ่ม · ซ่อน toolbar กราฟ · ปรับ filter ให้ค้นหาง่ายขึ้น · แก้ข้อความที่เขียนผิด
แก้กันหลักสิบถึงหลักร้อยบรรทัดต่อครั้ง
-
มี.ค.ยังหน้าบ้านเป็นหลักหน้าบ้าน + แอปคนขับ
เริ่มขยับไปแตะแอปคนขับ · วันสุดท้ายของเดือนเกิด commit แรกในระบบหลังบ้าน คือรวมข้อความ error ที่กระจัดกระจายมาไว้ที่เดียว
ประตูบานแรกของงานหลังบ้าน
-
เม.ย.250+ commitsหลังบ้านเต็มตัว
รื้อโครงสร้าง service คิดเงิน · รื้อระบบรายงานครั้งใหญ่ (งานหลังบ้านกว่า 110 ครั้ง)
ขนาดงานพุ่งเป็นเฉลี่ยเกือบ 1,000 บรรทัดต่อ commit
-
พ.ค.–มิ.ย.150–180 commits/เดือนลงฟีเจอร์
คิดเงินรายสัญญาแต่ละรูปแบบ · ระบบรายงาน · การ export ข้อมูล
ช่วงเดินเครื่องนิ่งๆ
-
ก.ค.repository ใหม่คุณภาพ + เอกสาร
ชุดทดสอบ E2E อัตโนมัติ · คู่มือผู้ใช้กลับมาคึกคัก
ระบบนิ่งพอจะเขียนสอนคนอื่นใช้ได้แล้ว
-
ส.ค.ช่วงส่งมอบความปลอดภัย + ส่งขึ้นจริง
งานความปลอดภัย · monitoring · deploy ขึ้น Production ต่อเนื่อง
ช่วงของเรื่องเล่าท้ายโพสต์นี้
หมุดที่ผมชอบที่สุดคือ commit แรกในระบบหลังบ้านช่วงปลายเดือนมีนาคม เนื้องานของมันคือ…การจัดระเบียบ ข้อความ error ที่กระจัดกระจายให้มารวมอยู่ที่เดียว ฟังดูเป็นงานของคนขี้รำคาญแบบ QA สุดๆ ใช่ไหมครับ แต่นั่นแหละคือประตูบานแรก และอีกสองเดือนถัดมาก็กลายเป็นการรื้อ service คิดเงินทั้งตัว
รวมทั้งเส้นทางราว 7 เดือน มี commit จากผม (ซึ่งจริงๆ เป็น AI คู่หูมากกว่า 🤣) กว่า 1,000 ครั้ง คิดเป็นโค้ดและเอกสารราว 260,000 บรรทัด (ตัดไฟล์ที่เครื่องมือสร้างอัตโนมัติออกแล้ว) แต่สิ่งที่ผมชอบที่สุดไม่ใช่จำนวนบรรทัด แต่คือ “ความชัน” ของมัน — จากคนที่แก้ปุ่มทีละไม่กี่บรรทัด ไปถึงคนที่รื้อ service คิดเงินทีละพันบรรทัด ห่างกันแค่สองเดือน ถ้าไม่มี AI อาจต้องนับกันเป็นปี

อีกมุมที่สนุกไม่แพ้กันคือสถิติฝั่ง “บทสนทนา” ครับ ผมลองให้ AI ย้อนไปนับบันทึกการทำงานของตัวมันเองในโปรเจกต์นี้ (เท่าที่ log ยังเหลืออยู่ ราวสองเดือนล่าสุด) พบว่ามีเซสชันทำงานร่วมกัน 131 ครั้ง ใน 38 วันทำงาน ผมพิมพ์สั่งงานทั้งหมด 782 ข้อความ แต่ AI ลงมือทำงานจริงไปกว่า 15,000 ครั้ง ทั้งรันคำสั่ง แก้ไฟล์ อ่านโค้ด เฉลี่ยแล้ว คนสั่ง 1 ครั้ง AI ทำงานต่อเนื่องราว 20 ขั้น ตัวเลขนี้อธิบายวิธีทำงานยุคใหม่ได้ดีมาก คือคนทำหน้าที่ชี้เป้าและตัดสินใจ ส่วนแรงงานลงมือจริงๆ ปล่อยให้ AI วิ่ง
ช่วงพัฒนา — งานสารพัดอย่าง และของจริงชื่อว่า “ระบบคิดเงิน”
งานช่วงพัฒนาไม่ได้มีแค่เรื่องเดียวนะครับ เนื้องานกระจายไปทั่วระบบ ทั้งสัญญาและเส้นทางวิ่ง การบันทึกเที่ยววิ่งของรถแต่ละคัน การ import/export ผ่าน Excel ที่เจ้าหน้าที่ใช้ทุกวัน ฟีเจอร์ฝั่งแอปคนขับอย่างบันทึกการเติมน้ำมันพร้อมรูปหลักฐาน ระบบสิทธิ์ตามบทบาท ไปจนถึงรายงานสารพัดแบบ เรียกว่าจับครบตั้งแต่ปุ่มบนหน้าจอยันโครงสร้างฐานข้อมูล
ถ้าไล่จาก commit ที่ติดป้ายว่าเป็นงานฟีเจอร์ใหม่ นับได้ราว 340 ครั้งตั้งแต่วันที่รับไม้ต่อจนส่งงาน จัดกลุ่มออกมาได้ประมาณนี้ครับ
ระบบคิดเงินและวางบิล
เม.ย. – ส.ค.
- สูตรคิดเงินตามรูปแบบสัญญา ทั้งเหมาจ่ายรายเที่ยว คิดตามช่วงราคาน้ำมัน คิดเป็นเปอร์เซ็นต์ และคิดต่อคันหรือต่อคนขับ
- ค่าใช้จ่ายเพิ่มเติมรายครั้ง และรอบบิลแบบกำหนดเอง
- ใบแจ้งหนี้รถร่วม รวมถึงเที่ยวตีเปล่าและกรณีรถแทน
- ล็อกวันที่วางบิล กันลบเที่ยววิ่งที่ออกบิลไปแล้ว และดูตัวอย่างบิลก่อนออกจริง
สัญญาและเส้นทางวิ่ง
มี.ค. – ก.ค.
- ฟอร์มสัญญาหลายขั้นพร้อมตรวจความถูกต้องข้ามชั้น
- คัดลอกสัญญาเดิมเป็นร่าง และเก็บร่างอัตโนมัติกันงานหาย
- นำเข้า/ส่งออกแผนเที่ยววิ่งข้ามสัญญาผ่าน Excel
- กำหนดโปรไฟล์การคิดเงินรายคันภายในสัญญาเดียว
เที่ยววิ่งและการอนุมัติ
ก.พ. – ส.ค.
- สถานะร่าง / บันทึกแล้ว / อนุมัติแล้ว พร้อมกรองตามสถานะ
- อนุมัติและลบทีละหลายรายการ พร้อมสิทธิ์แยกสำหรับรายการที่อนุมัติแล้ว
- นำเข้าจาก Excel แบบดูตัวอย่างก่อนบันทึกและกันข้อมูลซ้ำ
- จำกัดเวลาบันทึกล่วงหน้า และคุมช่วงเวลาให้อยู่ในอายุสัญญา
รายงานและ dashboard
เม.ย. – ส.ค.
- รายงานรายได้คนขับ รายงานกิจกรรมรถรายวันแบบไทม์ไลน์ และตารางภาพรวมรถทั้งหมด
- ส่งออก Excel ได้ทุกรายงาน พร้อมรูปแบบและชื่อไฟล์มาตรฐานเดียวกัน
- dashboard รายได้แบบ realtime พร้อมแคชและรีเฟรชอัตโนมัติ
แอปฝั่งคนขับ
มี.ค. – ส.ค.
- บันทึกเที่ยววิ่ง เติมน้ำมัน ชาร์จไฟรถ EV และสมุดประจำรถ
- ถ่ายรูปหลักฐานแบบบีบอัดและแปลงไฟล์จากมือถือให้อัตโนมัติ
- ปรับเวลาให้อิงเขตเวลาไทยทั้งระบบ กันวันที่เพี้ยน
- แจ้งเตือนเมื่อมีเวอร์ชันใหม่ และงานสแตนด์บายสำหรับคนขับที่ไม่ผูกกับรถ
สิทธิ์และความปลอดภัย
มิ.ย. – ส.ค.
- สิทธิ์แยกรายหน้าและรายปุ่ม แทนการเปิดปิดทั้งเมนู
- ปิดช่องโหว่ตามรายงาน pentest โดยบังคับตรวจสิทธิ์ทุกจุดที่เขียนข้อมูลหลัก
- ลบแบบเก็บประวัติไว้ และเก็บ log การเปลี่ยนแปลงข้อมูลพร้อมรอบล้างข้อมูลเก่า
ชุดทดสอบและการเฝ้าระวัง
เม.ย. – ส.ค.
- ชุดเทส E2E ด้วย Playwright และ unit test พร้อมรายงาน coverage
- repository แยกสำหรับสร้างและล้างข้อมูลทดสอบบน dev/UAT
- เก็บ error จากเบราว์เซอร์ผู้ใช้จริง และตรวจสุขภาพระบบเป็นระยะ
คู่มือผู้ใช้
ก.พ. – ส.ค.
- เว็บคู่มือที่อัปเดตพร้อมระบบ พร้อมป้ายบอกหน้าที่เพิ่งแก้
- แถบสรุป "มีอะไรใหม่" ในแต่ละหน้า
- ตัวจำลองการคิดเงินให้ผู้ใช้ลองกดเองก่อนใช้จริง
อ่านมาถึงตรงนี้ Developer หลายคนคงมีคำถามในใจว่า “QA จะรู้ได้ยังไงว่าโค้ดที่แก้ถูกหลักการ แล้วถ้าวันหนึ่งมีคนมารับช่วงต่อ เขาจะอ่านรู้เรื่องไหม” เป็นคำถามที่ถูกต้องที่สุดครับ ผมถามตัวเองด้วยคำถามเดียวกันตั้งแต่วันแรก และรับมือด้วยสองข้อ
ข้อแรก — ยึดหลักการที่เป็นมาตฐาน หลักที่ใช้บ่อยที่สุดคือ DRY (Don’t Repeat Yourself) คือ logic เรื่องเดียวกันต้องมีอยู่ที่เดียว ฟังดูพื้นฐานมาก แต่มองด้วยสายตา QA มันคือการคุมความเสี่ยงตรงๆ เพราะโค้ดที่ Copy ไปแปะซ้ำ หมายถึงบั๊กที่ถูก Copy ไปด้วย วันไหนต้องแก้สูตรคิดเงิน ถ้า logic กระจายอยู่ห้าที่ พลาดที่เดียวเงินก็ผิดแล้ว ผมเลยเขียนกฎข้อนี้ลงในกติกาประจำโปรเจกต์ และทุกครั้งที่เห็น AI เริ่ม copy โค้ดไปแปะที่ใหม่ ผมจะสั่งให้รวมเป็นฟังก์ชันกลางทันที
ข้อสอง — ใช้เครื่องมือตรวจโค้ดทุกตัวที่มี ในเมื่อรู้ตัวว่าสายตาเราอ่านโค้ดไม่ขาดเท่า Developer ตัวจริง ก็ให้เครื่องมือเป็นตาแทนซะเลย ด่านตรวจที่วางไว้มีประมาณนี้
- ตอนเขียน — type checking ของ TypeScript ที่ฟ้องตั้งแต่ก่อนรัน และ ESLint คุมสไตล์โค้ดให้สม่ำเสมอ
- ตอนเปิด PR — ให้ AI หลายตัวสลับกัน review งานของกันและกัน เขียนด้วยตัวหนึ่ง ให้อีกตัวตรวจ งานสำคัญก็โยนให้ Gemini หรือ Codex ดูเป็นมุมมองที่สาม
- ตอนโค้ดเข้า dev — CI (GitHub Actions) รัน unit test พร้อมวัด coverage แล้วส่งเข้าเครื่องมือวัดคุณภาพโค้ด ซึ่งจะบอกทั้ง coverage, โค้ดซ้ำ และจุดที่เสี่ยง ที่สำคัญคือขั้น build ผูกไว้ว่าต้องรอด่านนี้ผ่านก่อน ถ้าเทสแดง build ไม่วิ่งต่อเลย
- ตอนขึ้น Production — แยกไปป์ไลน์ของ dev, UAT และ Production ออกจากกัน ฝั่ง Production สั่งรันเองด้วยมือเท่านั้น ต้องระบุ release tag และต้องมีคนกดอนุมัติก่อน ถึงจะเริ่ม build และ deploy ได้ จบแล้วยิงผลเข้าแชททีมทุกครั้งว่าสำเร็จหรือพังตรงไหน
บทเรียนใหญ่ของช่วงนี้คือ AI เก่งเรื่อง “ทำตามที่บอก” มาก แต่คนต้องเป็นฝ่ายถามว่า “แล้วเคสนี้ล่ะ” ทักษะการคิดถึง edge case ที่ QA ฝึกมาทั้งชีวิต กลายเป็นอาวุธที่มีค่าที่สุดในการทำงานคู่กับ AI
ช่วงทดสอบ — สนามที่ QA ได้เปรียบ
พอมาถึงช่วงทดสอบ อันนี้คือบ้านของผมเอง แต่วิธีทดสอบก็เปลี่ยนไปจากเดิมมาก
ผมให้ AI ช่วยสร้างชุดทดสอบ regression ครอบคลุมกว่า 100 เคส และชุด E2E smoke test ที่รันผ่าน browser จริงด้วย Playwright สิ่งที่เมื่อก่อนต้องใช้เวลาเป็นสัปดาห์ในการเขียนและดูแล ตอนนี้สร้างได้ในไม่กี่วัน
อีกชั้นที่เพิ่มเข้ามาคือ unit test ระดับฟังก์ชัน ซึ่งเมื่อก่อนผมมองว่าเป็นงานของ Developer ล้วนๆ ตอนจบงานมีไฟล์เทสรวมกันเกือบ 200 ไฟล์ทั้งสามระบบ เน้นหนักที่ฝั่งคำนวณเงินเป็นพิเศษ เพราะเป็นจุดที่ผิดแล้วเจ็บที่สุด แล้วต่อรายงาน coverage เข้ากับเครื่องมือวัดคุณภาพโค้ด ให้เห็นทุกครั้งที่เปิด PR ว่าโค้ดส่วนไหนยังไม่มีเทสคุม
แต่สิ่งที่ผมคิดว่าสำคัญกว่าตัวเทสเอง คือการวางระบบการทดสอบให้มันทำงานแทนเราได้
สคริปต์จำลองข้อมูลจากของจริงมาไว้ที่ dev — ปัญหาที่เจอบ่อยเวลาลูกค้าแจ้งบั๊กคือ บนเครื่อง dev ข้อมูลไม่เหมือนของจริง กดตามยังไงก็ไม่เจออาการ ผมเลยทำสคริปต์สำเร็จรูปไว้ สั่งทีเดียวจบ ได้ชุดข้อมูลที่มีหน้าตาแบบเดียวกับที่ลูกค้าใช้จริงมาอยู่บน dev (ตัดและปิดบังข้อมูลส่วนบุคคลก่อนเสมอ) พอมีเคสแจ้งเข้ามา ผมไล่ตามรอยได้ทันทีในสภาพแวดล้อมที่ปลอดภัย ไม่ต้องไปแหย่ระบบจริง
ชุดเทสฝั่งหน้าบ้านและฝั่ง API ที่รันเองอัตโนมัติ — ทุกครั้งที่มีฟีเจอร์ใหม่ขึ้นระบบ สคริปต์จะวิ่งตรวจให้เองว่าเส้นทางหลักยังใช้ได้อยู่ ทั้งฝั่งหน้าจอที่คนกดจริง และฝั่ง API ที่อยู่ข้างหลัง ไม่ต้องรอให้ใครว่างมานั่งไล่กดทีละหน้า ข้อดีที่เห็นชัดคือของที่เคยทำงานได้ ถ้าพังเพราะงานใหม่ เราจะรู้ตั้งแต่ตอนนั้น ไม่ใช่รู้จากลูกค้า
พูดง่ายๆ คือแทนที่จะเทสหนักตอนใกล้ส่งงาน ผมย้ายแรงไปลงที่ “ตัวช่วยที่รันซ้ำได้ทุกวัน” แทน
เทสจบแล้วยังไม่จบ — ต้องเฝ้าของจริงด้วย
เทสทั้งหมดที่เล่ามาตรวจได้แค่ “ก่อนขึ้นระบบ” แต่ของจริงพังตอนไหนก็ได้ ผมเลยค่อยๆ ต่อชั้นการเฝ้าระวังขึ้นมาบน Azure ทีละชั้น ซึ่งแต่ละชั้นเกิดจากคำถามเดียวกันว่า “ถ้าเรื่องนี้เกิดขึ้นตอนตีสาม จะมีอะไรบอกเราไหม” และที่สำคัญคือแต่ละชั้น เกิดมาเพื่ออุดจุดบอดของชั้นก่อนหน้า
ก่อนจะลงรายละเอียด ขอวางภาพรวมก่อนว่าทั้งระบบวางอยู่บน Azure ยังไง เพราะสิ่งที่ผมได้จากมันไม่ใช่แค่ “ที่ฝากเว็บ” แต่คือของที่ปกติต้องมีทีม infra ทำให้
คนใช้งาน
ที่รันระบบ · App Service
แยกเครื่องของ dev, UAT และ Production ออกจากกัน อัปเดตทีละตัวได้โดยไม่กระทบกัน
ที่เก็บข้อมูล
ต่อฐานข้อมูลด้วยตัวตนของแอปเอง (Managed Identity) ไม่ต้องเก็บรหัสผ่านไว้ในโค้ด ส่วนลิงก์รูปเป็นลิงก์ที่เซ็นแล้วและหมดอายุตามเวลา ไม่ใช่ลิงก์เปิดสาธารณะถาวร
ที่คอยเฝ้า
เห็นทั้งฝั่งเซิร์ฟเวอร์และฝั่งจอผู้ใช้จริง — รายละเอียดอยู่ในสี่ชั้นถัดจากนี้
ที่ส่งของขึ้นระบบ
คนสั่ง deploy ได้จากที่เดียว มีร่องรอยว่าใครกดอนุมัติและขึ้นเวอร์ชันไหน
-
1
เซิร์ฟเวอร์ยังตอบอยู่ไหม
เก็บ log ทุก request ที่เข้าระบบ และตั้งแจ้งเตือนเมื่อเจอ error ฝั่งเซิร์ฟเวอร์ (5xx)
จุดบอด: ถ้า API ตอบ 200 ตามปกติ แต่ฐานข้อมูลล่ม จะไม่มีอะไรฟ้องเลย
-
2
ระบบยัง "ใช้งานได้จริง" ไหม
มี endpoint สำหรับตรวจสุขภาพที่ยิงคำสั่งแตะฐานข้อมูลจริงทุกครั้ง ถ้าต่อฐานข้อมูลไม่ได้จะตอบว่าใช้งานไม่ได้ทันที แล้วให้ Azure คอยยิงเช็กเป็นระยะจากนอกระบบ
จุดบอด: หลังบ้านปกติดี แต่หน้าเว็บขาวทั้งหน้าเพราะ JavaScript พัง ฝั่งเซิร์ฟเวอร์ไม่รู้เรื่องด้วยเลย
-
3
ผู้ใช้จริงเจออะไรบนจอ
ฝังตัวเก็บ telemetry ในเบราว์เซอร์ (Application Insights) จับ JavaScript error, request ที่ยิงแล้วล้ม และหน้าที่คนเข้าใช้จริง ทำให้รู้ว่าใครเจอจอขาวก่อนที่จะมีใครโทรมาแจ้ง
จุดบอด: งานที่ทำงานเบื้องหลังตามเวลา ไม่มีผู้ใช้นั่งดู ถึงไม่ทำงานก็ไม่มีใครรู้
-
4
งานเบื้องหลังยังเดินอยู่ไหม
งานคำนวณบิลตามรอบจะเขียน log ทุกครั้งที่รันจบ แม้รอบนั้นไม่มีบิลต้องออกสักใบ พูดอีกแบบคือ "ความเงียบ" กลายเป็นสัญญาณเตือนแทน
กติกาที่ตามมา: deploy เสร็จต้องเปิดหน้าจอเฝ้าจนตัวเลขนิ่ง ไม่ใช่เห็นคำว่าสำเร็จแล้วปิดจอ
แล้วของพวกนี้เวลาเปิดดูจริงหน้าตาเป็นยังไง? ประมาณนี้ครับ — หน้าจอจำลองที่ผมวาดขึ้นใหม่ ให้เห็นว่าข้อมูลชุดไหนดูได้บ้าง (ตัวเลขและข้อความเป็นของสมมติ)
| เวลา | ระดับ | สิ่งที่เกิดขึ้น |
|---|---|---|
| 03:12:04 | error | คำขอออกรายงานล้มเหลว — หมดเวลาเชื่อมต่อฐานข้อมูล |
| 02:55:31 | warn | คำสั่งค้นข้อมูลใช้เวลา 4.2 วินาที (เกินเกณฑ์ 2 วินาที) |
| 01:00:02 | info | งานคำนวณบิลตามรอบทำงานจบ — รอบนี้ไม่มีบิลต้องออก |
| 00:47:18 | error | หน้าเว็บฝั่งผู้ใช้เจอ JavaScript error ที่หน้ารายการเที่ยววิ่ง |
| 00:15:00 | info | ตรวจสุขภาพระบบจากนอกระบบ — ต่อฐานข้อมูลได้ปกติ |
คลิกที่แถวไหนก็ไล่ต่อได้ว่าคำขอนั้นมาจากหน้าไหน ผู้ใช้คนไหน ใช้เวลาช่วงไหนนานที่สุด และเกิดซ้ำกี่ครั้งในช่วงเวลาเดียวกัน
สองเรื่องที่ต้องคิดพร้อมกันตอนวางระบบเฝ้าระวังคือ ความเป็นส่วนตัวและค่าใช้จ่าย ข้อมูลที่ส่งออกไปต้องตัดส่วนที่ระบุตัวลูกค้าออกก่อนเสมอ (เช่น พารามิเตอร์ท้าย URL ที่มีรหัสลูกค้าติดไปด้วย) และเก็บเฉพาะสิ่งที่ได้ใช้จริง เพราะ telemetry ที่เก็บแบบไม่คิดอะไรจะกลายเป็นบิลก้อนใหม่ให้ลูกค้าโดยไม่ได้ตั้งใจ
ช่วงส่งงาน — ดูแล 3 environment ด้วยตัวคนเดียว
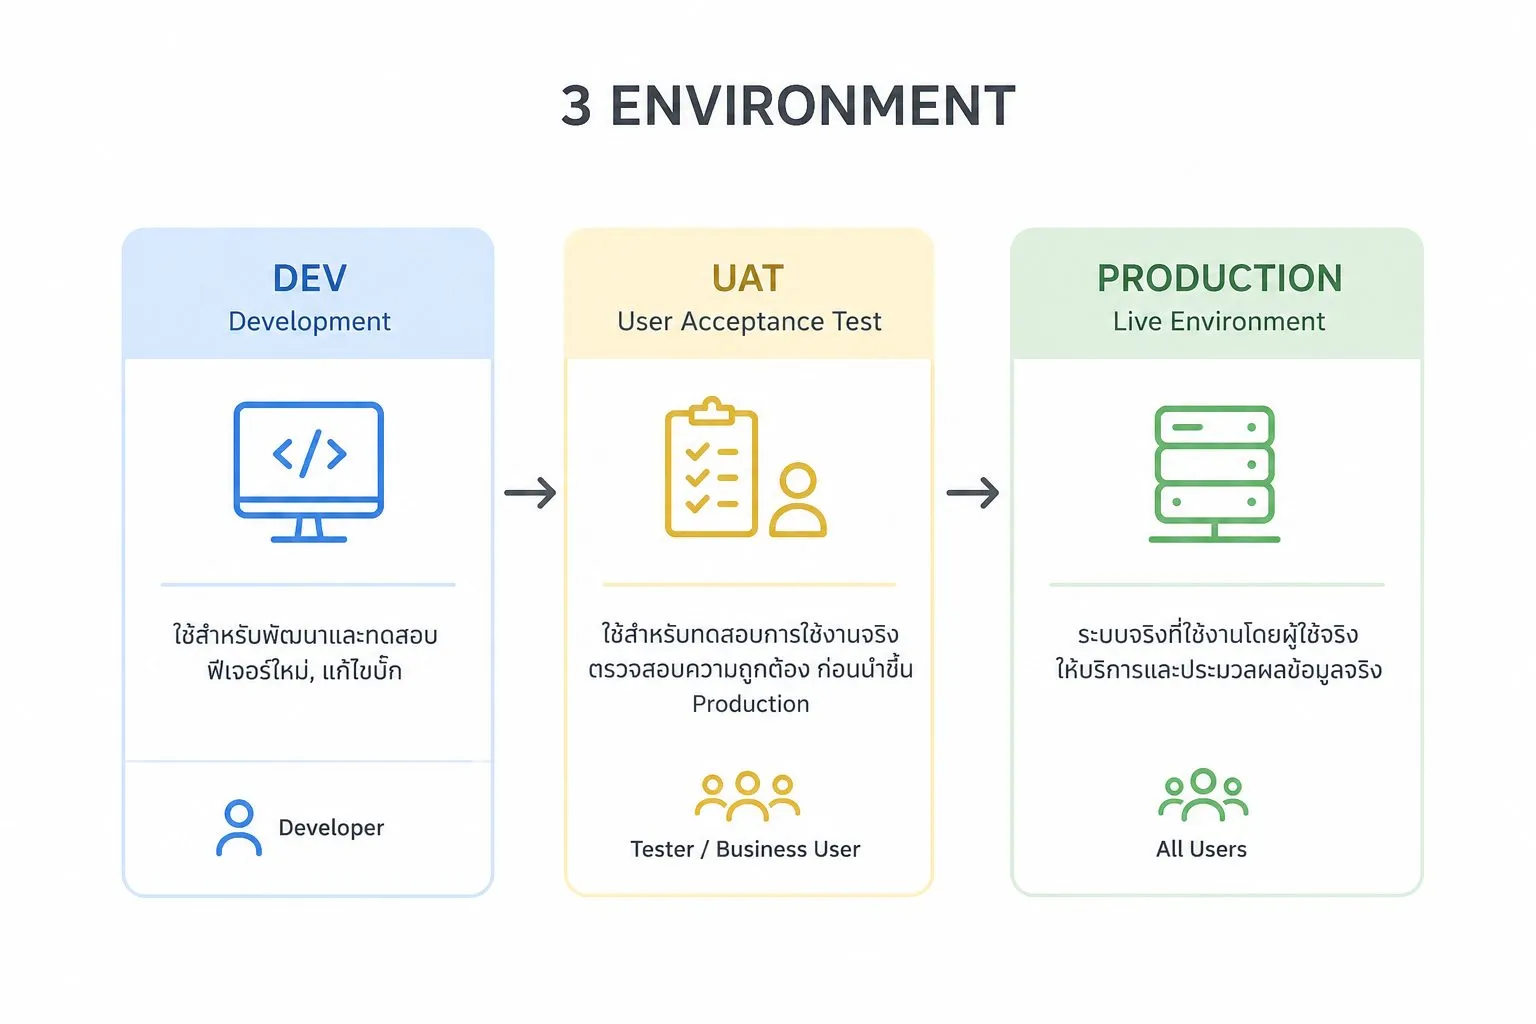
ระบบนี้มี 3 Environment คือ DEV, UAT และ PROD ปกติงานพวกนี้ต้องมีทีม DevOps ดูแล แต่ในโปรเจกต์นี้ คนที่กด Deploy, รัน Database Migration, ตั้ง Monitoring และไล่ดู Log คือคนเดียวกับคนที่เขียนโค้ด คือผมเอง
สิ่งที่ทำให้รอดคือการตั้งกฎกันตัวเองไว้ล่วงหน้า
- ห้าม push ขึ้น branch หลักตรงๆ ต้องผ่าน Pull Request และ review เสมอ ถึงแม้คน review จะเป็น AI ก็ตาม
- migration ทุกตัวต้องรันบน dev และ UAT ให้ผ่านก่อน ถึงจะแตะ Production ได้
- deploy Production เฉพาะช่วงที่คนใช้งานน้อย ซึ่งรู้ได้จากการเอา log การใช้งานจริงมาให้ AI วิเคราะห์หา pattern ว่าวันไหนเวลาไหนคนใช้เยอะสุด
- มีระบบ monitoring และ alert ที่ตั้งขึ้นโดยให้ AI ช่วย ตั้งแต่ที่ยังไม่เคยทำมาก่อนในชีวิต
แต่ผลข้างเคียงอย่างหนึ่งของการที่คนคนเดียว deploy ได้เรื่อยๆ คือ ฟีเจอร์ใหม่งอกเร็วมาก แก้เสร็จวันนี้ ขึ้น UAT พรุ่งนี้ ผ่านแล้วขึ้น Production ต่อเลย พอทำแบบนี้ไปหลายเดือน สิ่งที่ตามมาไม่ทันคือ “แล้วของใหม่พวกนี้ใช้ยังไง” คนใช้งานจริงเริ่มถามซ้ำๆ เรื่องเดิม ทีมก็ต้องมานั่งตอบใหม่ทุกรอบ เอกสารเก่าที่มีอยู่ก็กระจายกันคนละที่ ทั้งไฟล์ Word ในเครื่อง ไฟล์ที่ลูกค้าส่งมา และข้อความในแชท
นี่แหละครับคือที่มาว่าทำไมผมถึงต้องหันไปหาเฟรมเวิร์กมาทำคู่มือผู้ใช้อย่างจริงจัง แทนที่จะเขียนเอกสารทีละไฟล์แล้วส่งต่อกันไปมา คือทำให้คู่มืออยู่ในรูปแบบเดียวกับโค้ด มีที่อยู่ที่เดียว เปิดดูออนไลน์ได้ และอัปเดตพร้อมกับตอนที่ระบบเปลี่ยน เรื่องนั้นผมแยกไปเล่าไว้อีกโพสต์แล้ว ตั้งแต่ตอนที่เอกสารยังกระจัดกระจายจนหาไม่เจอ ไปจนถึงเหตุผลที่เลือกใช้ Astro มาทำเป็นศูนย์กลางเอกสาร — เอา AI มาช่วยอ่านเอกสาร แล้วรวมเป็นศูนย์กลางด้วย Astro
มีอยู่ช่วงหนึ่งระบบถูกทดสอบเจาะระบบ (pentest) จากทีมภายนอก แล้วพบช่องโหว่เรื่องการยกระดับสิทธิ์ผู้ใช้ ผมเอารายงานนั้นมานั่งไล่ปิดทีละข้อกับ AI ทั้งที่ถ้าเป็นเมื่อก่อน แค่อ่านรายงาน pentest ให้เข้าใจยังยากเลย
ช่วงไฟไหม้ — วันที่ระบบล่มต่อหน้าต่อตา
แล้ววันที่กลัวที่สุดก็มาถึงจริงๆ
หลัง deploy รอบหนึ่งในช่วงที่ยังมีคนใช้งาน ระบบล่มไปประมาณ 18 นาที ผู้ใช้เข้าระบบไม่ได้ ลูกค้าเริ่มถาม และคนที่ต้องหาคำตอบมีอยู่คนเดียว ตอนนั้นสิ่งที่กดดันไม่ใช่การแก้โค้ด แต่คือการตอบให้ได้ว่า “เกิดอะไรขึ้น” ก่อนที่จะตัดสินใจว่าจะ rollback หรือแก้เดินหน้าต่อ
สิ่งที่ทำคือเปิด Claude Code แล้วเทของทุกอย่างที่มีให้มันอ่าน — log จากเซิร์ฟเวอร์ช่วงก่อนและหลัง deploy, ค่า metrics จาก monitoring และไทม์ไลน์ว่าอะไรเกิดขึ้นตอนกี่โมง งานที่คนทำไม่ทันในนาทีนั้นคือการกวาดสายตาผ่าน log หลายหมื่นบรรทัดเพื่อหาว่าอะไรเริ่มผิดปกติเป็นอย่างแรก ซึ่งเป็นงานที่ AI ทำได้ในไม่กี่นาที
แต่สิ่งที่ AI ทำแทนไม่ได้คือ การตั้งคำถามว่าจะสงสัยอะไรก่อน ผมไล่ทีละสมมติฐานแบบเดียวกับตอนไล่บั๊ก โค้ดที่เพิ่งขึ้นไปพังเองหรือเปล่า, คนใช้งานพุ่งขึ้นผิดปกติไหม, ฐานข้อมูลตายหรือเปล่า แล้วให้ AI หาหลักฐานมาสนับสนุนหรือหักล้างทีละข้อ ตัดออกไปทีละอันจนเหลือข้อเดียวที่หลักฐานตรงกันหมด
คำตอบคือ ตอน restart หลัง deploy ระบบพยายามโหลดข้อมูลจำนวนมากเข้า cache พร้อมกันทันที จนแย่ง connection ของฐานข้อมูลกันเอง request ของผู้ใช้จริงเลยไม่เหลือที่ว่างให้ทำงาน ระบบจึงเหมือนล่มทั้งที่เครื่องไม่ได้ดับสักเครื่อง — เป็นบั๊กที่ไม่มีทางเจอในห้องทดสอบ เพราะบน dev ไม่มีทั้งข้อมูลขนาดจริงและคนใช้งานจริงพร้อมกัน
จากเหตุการณ์นั้นเราแก้ให้การโหลด cache ค่อยๆ ทยอยทำและไม่แย่งทรัพยากรกับผู้ใช้ ได้กฎใหม่มาอีกข้อว่า deploy เสร็จต้องเฝ้าจนตัวเลขนิ่งจริง ไม่ใช่เห็นคำว่าสำเร็จแล้วปิดจอ และได้ของแถมคือชั้นเฝ้าระวังที่เล่าไปก่อนหน้านี้ ซึ่งส่วนใหญ่เกิดหลังวันนั้นทั้งนั้น
ถ้าไม่มี AI เหตุการณ์แบบนี้ปกติต้องใช้ทีม 3-4 คนช่วยกันไล่ และอาจกินเวลาเป็นวัน แต่รอบนั้นเราหาต้นตอเจอภายในชั่วโมงเดียว นี่คือจังหวะที่ผมรู้สึกจริงๆ ว่า AI ไม่ได้แค่ช่วยเขียนโค้ด มันทำให้คนหนึ่งคนรับมือสถานการณ์ระดับที่เมื่อก่อนต้องใช้ทั้งทีม โดยที่คนยังเป็นฝ่ายตั้งคำถามและตัดสินใจอยู่เหมือนเดิม

บทเรียนจากทั้งเส้นทาง
ถ้าให้สรุปสิ่งที่ได้เรียนรู้จากโปรเจกต์นี้ทั้งโปรเจกต์ ผมขอสรุปเป็นข้อๆ แบบนี้
1. AI ไม่ได้ทำแทนเรา มันคูณแรงเรา คนที่รู้ว่าต้องถามอะไร ตรวจอะไร และตัดสินใจอะไร จะได้ประโยชน์จาก AI มหาศาล ส่วนคนที่สั่งแล้วรับโค้ดไปใช้เลย จะได้ระบบที่พังแบบไม่รู้ตัว
2. ทักษะ QA คือทักษะของยุค AI ความขี้สงสัย การคิดถึง edge case การไม่เชื่อจนกว่าจะเห็นหลักฐาน ทั้งหมดนี้คือสิ่งที่ AI ยังทำแทนไม่ได้ และเป็นสิ่งที่ทำให้งานของ AI เชื่อถือได้จริง
3. วินัยสำคัญกว่าความเก่ง กฎที่ตั้งไว้ล่วงหน้า ทั้งเรื่อง Pull Request, migration, ช่วงเวลา deploy คือสิ่งที่กันไม่ให้ความเร็วของ AI กลายเป็นความเสียหาย ความเร็วที่ไม่มีเบรก ไม่ใช่ข้อได้เปรียบ แต่คืออุบัติเหตุที่รอวันเกิด
4. เริ่มจากงานที่เรารู้ดีที่สุด ผมไม่ได้เริ่มจากให้ AI เขียนระบบทั้งระบบในวันแรก แต่เริ่มจากเรื่องเอกสาร แล้วขยับมาเรื่องเทส ซึ่งเป็นบ้านของตัวเอง พอมั่นใจแล้วค่อยขยับไปเรื่องที่ไม่เคยทำ ความมั่นใจมันสะสมได้
สุดท้ายนี้ ถ้าคุณเป็น QA หรือทำงานสายไหนก็ตามที่ไม่ใช่ Developer แล้วเคยคิดว่า “การสร้างระบบมันไกลตัวเกินไป” ผมอยากบอกว่ากำแพงนั้นเตี้ยลงมากแล้วครับ มันไม่ได้หายไป ยังต้องเรียนรู้ ยังต้องระวัง ยังต้องรับผิดชอบกับสิ่งที่ส่งออกไป แต่จากคนที่เคยยืนอยู่ฝั่ง “ทดสอบของที่คนอื่นสร้าง” มาทั้งชีวิต วันนี้การข้ามมาฝั่ง “สร้าง” มันเป็นไปได้จริงๆ แล้ว
แล้วคุณล่ะครับ มีอะไรที่อยากสร้างแต่คิดว่าตัวเองทำไม่ได้บ้าง ลองหยิบมันขึ้นมาอีกครั้ง แล้วชวน AI นั่งข้างๆ ดูสักตั้ง
อ่านแล้ว ครั้ง